


今、もっとも熱心に紙の本を読んでいるのは人ではない。AIである。
大手出版取次「日販(日本出版販売)」が、米AI開発企業「アンソロピック」に書籍を大量販売していたことがわかった。
出版取次の日販、米AI企業に書籍を大量販売か 業界団体が説明要求:朝日新聞
アンソロピックは、AIに学習させるため、数百万冊の書籍を裁断・スキャン・デジタル化し、その後廃棄(破壊スキャン)した過去がある。今回も、同様の処理をした可能性が極めて高い。出版社団体「日本書籍出版協会」は、日販に対し説明を求めている。
怒れる出版社
出版社側の怒りは容易に想像がつく。彼らにとって、本はAIに読ませるためのものではない。人に読んでもらうためのものだ。データではない。創作物だ。同協会の「造本装幀コンクール※)」を見ればわかる。紙質・装幀にこだわり、重み・厚みがある受賞作は、手元に置いておきたくなるものばかり。これらが、人に読まれることなく裁断され、データだけがAIに喰われ、残った紙面は捨てられる。出版社でなくとも痛ましく感じるのではないか。
※)日本書籍出版協会・日本印刷産業連合会共済
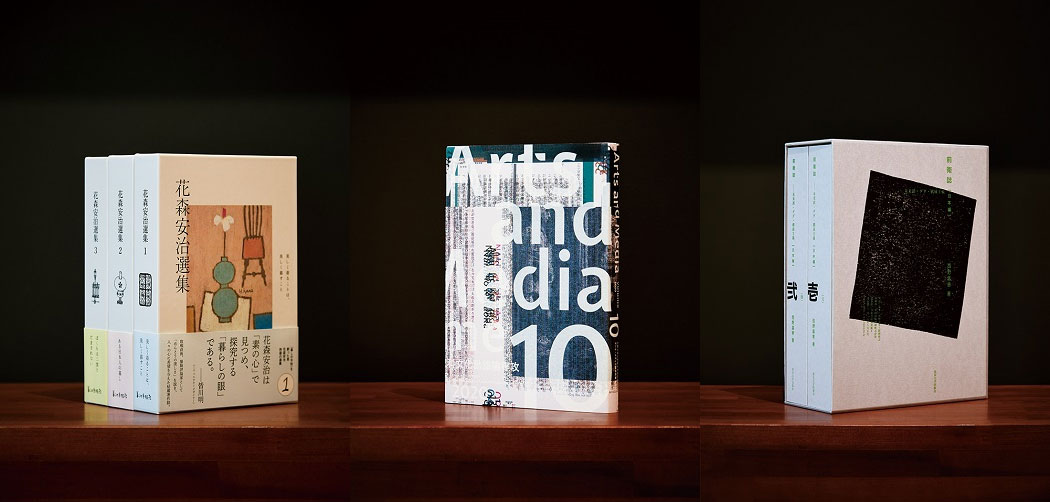
受賞作
造本装幀コンクールより
裏切られたという思いもあるだろう。紙の本において、出版社・印刷会社・取次・書店は一蓮托生の関係にある。日販は、出版各社とともに経済産業省主導の「出版産業における返品削減研究会」の委員に名を連ね、本を存続させるための施策を講じてきた。「滞在型書店 文喫」「ブックホテル 箱根本箱」も、その一環だ。どちらも、本を売ることが目的ではない。「紙の本と接してもらうこと」が目的だ。
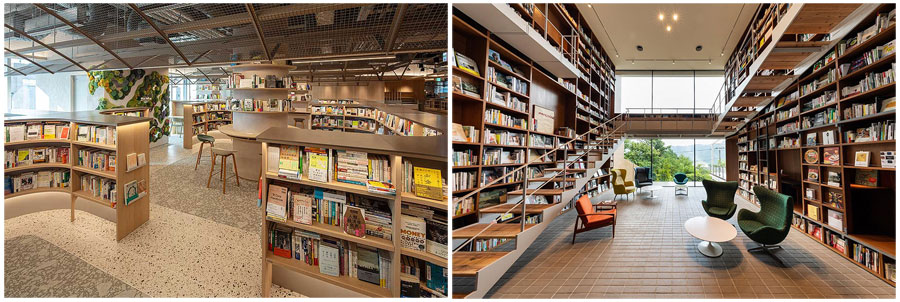
左:BUNKITSU(文喫)TOKYO、右:ブックホテル 箱根本箱
もし、紙の本が無くなれば、電子書籍を扱わない取次は、付加価値を創出できなくなり、そのダメージは計り知れない。「紙の本を守るべき」企業であり、実際に守ってきた日販が「破壊スキャン」を行うアンソロピックに本を売り渡していたことに、業界は衝撃を受けている。
ネットはAIの排泄物で溢れてる
そもそも、なぜアンソロピックは紙の本を欲しがるのか。AIの学習データに使うのであれば、ネット上のデータを使った方がはるかに楽なはず。わざわざ手間のかかる紙の本を購入するのはなぜか?
ネットは「汚染」されているからだ。
ある時期から、ネット上に、オリジナリティがない「一般論」が溢れるようになった。AIが書いた文章、あるいは、書いた文章を「参考にして」書かれた文章である。
だが、AIの文章はまちがいを含んでいる。AIがまちがい含みの文章を学習し、それを学習したAIがさらにまちがい含みの文章を書き……。こうしたことが繰り返され、AIが書く文章は現実から乖離していく。
このような文章(やデータ)を「AIスロップ」と呼ぶ。スロップ(slop)とは、残飯やカス、排泄物のことをいう。いまやネットデータは、AIの排泄物まみれなのだ。
そんな汚いデータを、わが社のAIに学習させるわけにはいかない。ではどうする? クリーンなデータはどこにある?……そう。紙の本だ。
「Anthropicは、世界最高水準のAIを実現するには、書籍を利用するのが最も費用対効果の高い手段である、と確信するに至った」
このような記述が、アンソロピックの裁判資料にある。過去、アンソロピックは海賊版書籍700万冊をダウンロードし、著作権者に訴えられている。その後、大手出版社とのライセンス契約を模索するが実現せず、最終的に選んだのが「紙の本をスキャンすること」だった。
紙の本を購入したうえでスキャン・廃棄すれば法的問題がクリアされる。かつてグーグルが行っていたカメラ撮影を用いる「非破壊スキャン」ではなく、本を裁断しスキャナで一気に読み込む「破壊スキャン」でデータ化すれば安価にすむ。アンソロピックが選んだのは、最も安く簡単な方法だった。スキャンプロジェクトの責任者には以下の任務が課された。
「世界中のあらゆる書籍を手に入れること」
(obtaining “all the books in the world”)
こうして、アンソロピックは日本の書籍も視野に入れることとなる。
裁判資料内の「NIPPAN」
日販のアンソロピックへの書籍販売が明らかになったのも裁判資料からだった。”Nippan Japan”(日販)という企業名が資料に複数回登場し、「購入した書籍はスキャンする意向」とみられる記述もあった。日販は朝日新聞の取材に対し
「AI学習向け用途と認識したうえで販売した事実はない」
と回答しているが、言い訳にしてもかなり苦しい。業界内での信用低下は免れないだろう。
汚物を食べる人間たち
「世界最高のAIトレーニングデータは本棚に並んでいる」
AI Companies Are Buying Tons of Old Books Because They’re Free of AI Slop|404media
このようなキャッチコピーでAI企業に「紙の本」を斡旋する企業が出現している。米国のISBNdb社※)である。「世界最大の書籍データベース」を自称する同社は、2022年以前の書籍データを「生成AIの汚染がない」「ネットから取得できない査読済みの専門知識」として売り込んでいる。
※「ISBNdb」は営利民間(小規模)企業。ISBNを管理する機関(国際ISBN機関)ではない。ISBNdbのキャッチコピーは現在削除されている
いまや、AIは自らが汚染したネットに見切りをつけ、「紙の本」という新たな狩場でデータを食い散らかしている。そして、AIが吐き出した汚物を熱心に読んでいるのは、私たち人間なのだ。
【参考】
・UNITED STATES DISTRICT COURT NORTHERN DISTRICT OF CALIFORNIA Case 3:24-cv-05417-WHA(判決文)
コメント
いくつかの論点が入り組んだ議論です。
まず第一に、「紙質・装幀にこだわり、重み・厚みがある」という書物の持つ一面は、「有体物」としての書物なのですね。有体物というのは、媒体としての書籍で、セルロースの薄片に特殊なパターンにインクを塗布し、これを重ねて綴じたもので、まさに「重み・厚みがある」存在です。
そして重要な点は、「有体物としての書籍にかかわる権利は、書籍の所有者に帰属する」という点で、所有者は己の所有する書籍をいかようにも処分することができるのですね。つまり、積んでおくのも枕にするのも、切り刻むのも所有者の胸先三寸、というわけです。だから、自炊しようという人が装丁などには気を掛けずに、書物をバラバラにしてスキャンすることに対して、出版社側としては、文句をつける権利はないのですね。
書物には、装丁もあり、紙質やその他の物理的諸元にも出版社側のこだわりがあるでしょうし、思い入れもあるということは理解できます。でも、出版物といいますのは、所詮は量産品、複製品なのですね。これは、グーテンベルクの偉大な発明からの流れであって、それ以前の一品生産的な書物から、プレスによって大量に同じものが生産できる、活版印刷術の発明をその嚆矢としているのですね。だから、そのうちの一部が毀損されようと、出版社側としてはさして気に留める必要もないはずなのですね。
ただしこれは、「有体物」としての書籍にかかわる権利であって、スキャンしてデジタルデータにするという行為には、「内容の複製」という、「無体物」の利用も発生しております。無体物(内容)にかかわる権利は、書物の所有権にかかわりなく、著作者側が保有しており、この点が次の議論となります。
書籍をバラバラにしてこれをスキャンしてデジタルデータにする行為は「自炊」と呼ばれて、以前から一部で行われておりました。デジタルデータにすれば、保管場所も取らず、持ち運びも容易で、サーチもできる。このような行為は、個人でやる分には合法的なのですね。つまり、著作権法第30条は、もっぱら家庭内での利用を目的として個人が行う複製は、「私的複製」として、著作権が働かないと定められております。自炊は自分でやる限り、私的複製物を作る行為であって、合法、ということになります。
一方、「自炊業者」という、自炊を専門に引き受ける業者が存在しまして、この手の営業行為は違法となります。あくまで自炊は自分でやることが条件です。あたりまえの話ですけど、著作権法第三十条も「その使用する者が複製することができる」と規定しているのですね。
AIを業とする者が複製物を作るとなりますと、この部分には議論の余地があります。つまり、AIでの利用が「もっぱら家庭内」であるのか、が問われることになります。我が国の著作権法では、これはちょっと難しいのではないかと思いますが、どうなのでしょうか。
なお、無体物にかかわる権利は著作者に帰属し、今回のケースでは日版とは直接の権利関係はありません。アンソロピックに対して著作権侵害訴訟を起こす主体は、それぞれの本の著者ということになります。ただ、多数の著者が関わっており、日版がこれらの訴訟を取りまとめるといったことはあり得るのではないかと思います。いずれにせよ、著者の側から声をあげることが肝要ではないでしょうか。
以上の議論は、日本の著作権法、特に第三十条(私的複製)をベースにした議論ですが、米国の著作権法は「フェアユース」という包括的規制となっております。GoogleのLegalヘルプによりますと、フェアユースが認められるのは、主に次の4つの場合であるとされております。
・利用の目的と特性(その利用が、商用か非営利の教育目的かなど):これに関しては、商用利用ですから、フェアユースには該当しないはずです。
・著作権のある著作物の性質:フィクションはフェアユースになりにくいというのですが、AI業者の利用するのは、もっぱらノンフィクションのはずで、こちらはAI業者をサポートします。
・著作権のある著作物全体との関連における使用された部分の量および実質性:一部を利用する場合はフェアユースとされやすいけど、全部を利用すると困難としております。今回のAIの利用は全部のはずですから、フェアユースにはなりにくいはずです。
・著作権のある著作物の潜在的市場または価値に対する利用の影響:こちらは、 AIに問い合わせれば答えが得られるようになれば、書籍は不要となり、書籍の価値を大いに損ねるとみなされるでしょう。
と、いうわけで、米国著作権法の観点からは、AIに大量の書籍を読み込ませ、AI利用者にこの内容に基づく回答を行う行為は、米国著作権法の例外規定であるフェアユースと認められることは難しいように、私には思われます。
その他、ネット上の情報がAIに汚染されているという問題ですが、この手の問題は、AIが最も得意とするところだと思いますよ。AIに汚染された情報というのは、どこかで聞いたような話、ということでしょう。大量の情報にアクセスできれば、それぞれの情報の関連を見出すことも可能で、汚染状況も見極めがつくはずなのですね。
最近、私のブログにも、大量のアクセスが集中することが何度かありました。Whoisでアクセス元を見ることができるのですが、どうも、情報サービス関連業者である様子。おそらくは、AIの教育に私のブログを使用しているのでしょう。
もちろん私も、情報収集にネットを使っており、一部はAIの提供するものでもあるのですが、私の視点はAIとは全然別のものですから、賢いAIなら独自の視点として私のエントリーを重用してくれるはず。AIが私と同意見を述べるようになりますと、私としては、なかなかに喜ばしい話だと思うのですが、こういう考えは少数派なのでしょうか。情報をネットに公開している以上、賛同者が増えるのは喜ばしいことだと思います。
たとえそれが、人であっても、AIであっても、じゃないですか?