


7月1日から、ツイッターが閲覧できなくなるなどの障害が発生しています。その原因は、ツイッター側が十分説明していないため不明ですが、オーナーのイーロン・マスクはdata scrapingに対応するため、一時的にアクセスを制限したと説明しています。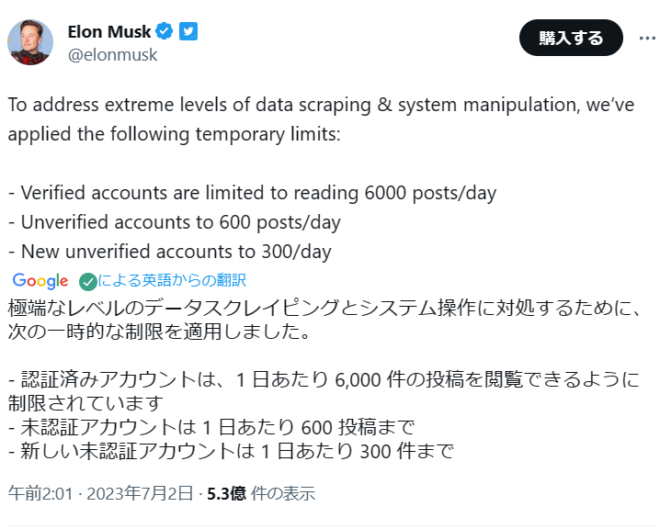
これによると認証アカウントは1日6000件、認証されていない既存のアカウントは600件、認証されていない新しいアカウントは300件に制限したようですが、このデータ・スクレイピングって何でしょうか。チャットGPTにきいてみました。
データ・スクレイピングは、コンピューター プログラムがWebサイトまたはプログラムからデータを抽出し、それをコンピューター上のスプレッドシートまたはローカルファイルに保存する手法です。これは、分析、処理、またはプレゼンテーションのために大量の情報を取得する効率的な方法です。 データスクレイピングは、さまざまな用途の結果を提供し、データ集約の側面を自動化します。
ツイッター閲覧制限 マスク氏「スクレーピング」批判に専門家はhttps://t.co/4cFeoNZD2e
イーロン・マスク氏はツイッター利用者が見ることができる投稿数を一時的に制限。ユーザーから「Twitter終わり」などと反発の声が上がり、「制限解除」「Twitterの代わり」などの言葉がトレンド入りしました
— 毎日新聞 (@mainichi) July 2, 2023
スクレイピングというのは「収集」とか「強奪」とか訳すこともありますが、ウェブサイトに大量にアクセスして、データを保存すること。元のデータを破壊するわけではありません。

"AIの為のスクレイピング戦争がいよいよヒートアップして、ウェブはオープンさと便利さを失うと思う。
redditがアプリを強制したり、Twitterがアカウントのないユーザーを弾いたり、Discordがインデックスされなくなったり。
この状況に対する良い解決策はまだわからない" https://t.co/BZX8TYI7lg
— A A A999 (@AAA18288605) July 1, 2023
本当にそんなことが起こってるんでしょうか。
Twitter障害はスクレイピングではなく“自己DDoS”が原因?https://t.co/kL2EtjkeMF
— ITmedia NEWS (@itmedia_news) July 1, 2023
ツイッター制限の理由は、急に次の使用が増えたから緊急対処
extreme levels of data scraping & system manipulationたぶん以下のような操作では?
・ツールで新規アカを自動取得して大量に操作
・DM送付業者も増加
・パスワードクラッキングも増加
・政治団体の大量投稿?pic.twitter.com/84ifpwpXt0— かってにシロクロ@AIは地球を救う (@Kumar_ShiroKuro) July 2, 2023
ブルームバーグによると、ChatGPTの作成者であるOpenAIは、書籍、記事、Webサイト、投稿、同意なく取得した個人情報など、インターネットから3000億語を秘密裏に収集した疑いで提訴されています。
ChatGPT's creator OpenAI is being sued for allegedly secretly scraping 300 billion words from the internet, including books, articles, websites, posts, and personal information that was obtained without consent, Bloomberg reports. pic.twitter.com/HwGmGEFfWZ
— KanekoaTheGreat (@KanekoaTheGreat) July 3, 2023
ツイッターのアクセス制限は、グーグル・クラウドの料金を払わなかったため、契約を切られたのが原因との説もあります。
これ原因に関係してるとしたら、一日や二日では制限解除されないのでは…
Twitterとgoogleの間の契約更新にかかる報道は憶測混じりで何が正しいか分かりませんが、契約期限の6月30日を過ぎ、7月になった途端こうなったということは…
早くなんとかして~https://t.co/K7PTk4y9x7
— sigh(サイ) (@just_a_sigh192) July 2, 2023
今に至るもツイッター社が正式の説明をしないので真相は不明ですが、生成AIは他のウェブサイトから大量にデータを収集することが必要です。それを「データの強奪」と呼ぶかどうかはともかく、ネット上の情報収集ルールは見直す必要があるでしょう。